内容分类
人格心理学
30 个侧面来自 NEO-PI-R 的 240 题、6×5 结构;BFI-2 用 15 个、BFAS 用 10 个 aspects;同名侧面跨量表不能预设等价。本文按 5 个 domain 列出全部 30 个 facet 英文名与中文描述,并给出两份报告同名指标的对齐三步框架。
作者: Fermat Institute
发布于: 2026年7月24日
更新于: 2026年7月24日
阅读时间:1 分钟
人工审核完成 · 2026年7月24日什么时候适合阅读这篇文章?
当你想把公开内容和测评、人格画像或职业建议串起来时,先从这篇文章的核心摘要开始。
这篇文章会替代正式判断吗?
不会。它只提供公开解释和行动线索,不替代医疗、法律或专业诊断。
内容分类
人格心理学
相关标签
大五人格、Big Five、Personality Test
两份大五报告,一份“果断”82,一份“果断”58,能直接比吗?先把结论摆前面:30 个侧面来自 NEO-PI-R 的 240 题、6×5 结构;BFI-2 用 15 个、BFAS 用 10 个 aspects;同名侧面跨量表不能预设等价,需先确认量表、定义和分数类型再比较。下面拆开讲:30 个 facet 从哪来、为什么不同大五工具的切法不一样、两份报告上的同名指标能不能直接对照。
如果你想把阅读转成自我测量,可以从测试入口开始。
当人们说“大五人格有 30 个侧面”时,他们说的是 NEO-PI-R(NEO Personality Inventory-Revised)这一具体量表的结构。根据 IPIP ESCS Technical Report(Goldberg & Saucier, 2016),NEO-PI-R 由 240 个题项组成,按 5 个 domain 各 6 个 facet 切分,共 30 个 facet(C-DEF-001)[S5]。这是 NEO-PI-R 这一具体工具的设计选择,而不是“大五”作为理论必须遵守的硬性规定。
需要声明边界:本节“240 题/30 facet/每域 6 个”的事实来自 IPIP ESCS 技术报告,NEO-PI-R 手册正文(Costa & McCrae, 1992)未直接访问,仅保留为书目级引用 [S3]。下文 30 个 facet 的英文名按 IPIP NEO Facets Table 核验(C-DEF-002)[S6];中文为审慎的描述性翻译,不同正式中译版本可能不同,请以原文为锚。
以上 30 个英文名按 IPIP NEO Facets Table 全部核验,未做删减或合并 [S6]。这里只列英文名称(括号中的中文为描述性翻译,非经授权的正式中文版本),不附构念定义,也不复制量表题项或手册受保护内容。
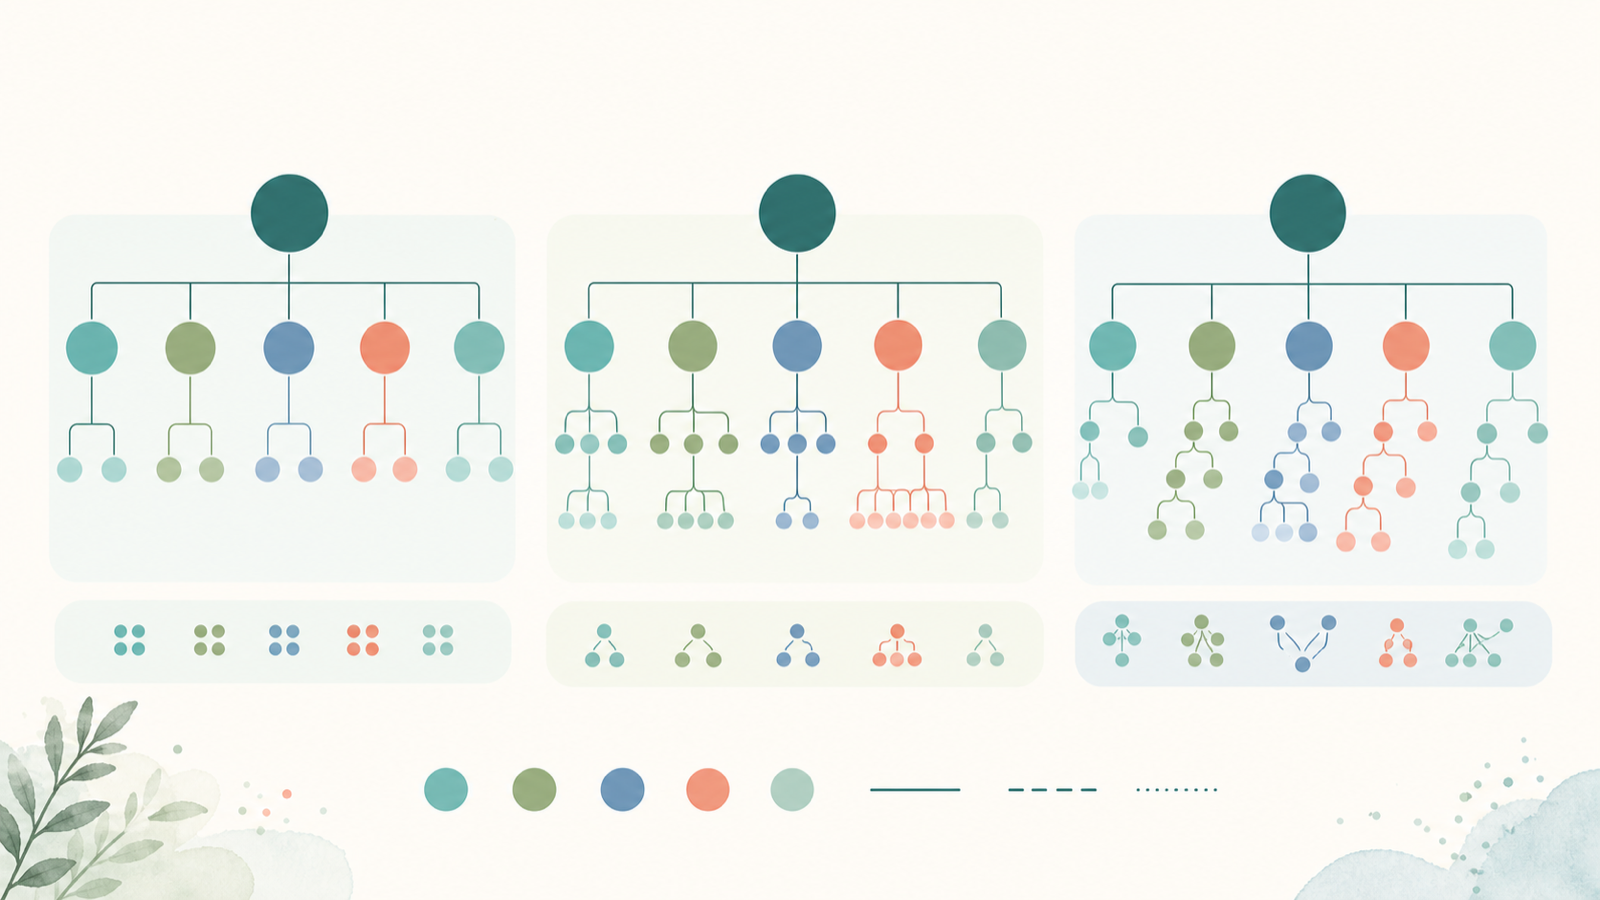
把 NEO-PI-R 的 30 个 facet 当成“大五的标配”,下一份报告就会让你困惑:BFI-2(The Next Big Five Inventory)只用 15 个 facet,每个 domain 3 个;BFAS 又是另一种切法。三者代表三种不同粒度,背后还藏着大五本身就是一个分层概念家族这件事。
BFI-2 的 15 个 facet。 Soto 与 John(2017)发表 BFI-2 时,目标是相对原版 BFI 提供更大带宽、保真度与预测力,并控制默认反应倾向;原版 BFI 并没有与 BFI-2 对应的正式 15 facet scales(C-EMP-006)[S2]。也就是说,BFI-2 自身有一个 5×3=15 的结构,它不是 NEO-PI-R 30 个 facet 的“短版”。
aspects 与 BFAS。 DeYoung、Quilty 与 Peterson(2007)在“Between facets and domains”一文中提出:在 Big Five domains(5 个)与 narrower facets(如 NEO-PI-R 的 30 个)之间,还存在一个中间层级,每个 domain 两个、共 10 个 aspects(C-EMP-007)[S4]。为测量这 10 个 aspects,作者构建了 BFAS(Big Five Aspect Scales),它是一套 100 题的量表,包含 10 个 aspect scales。在 DeYoung 等人(2007)的研究中,研究构建的这套 100 题 BFAS measure 在第二个样本(N=480)中得到验证。
这里要把两个概念分开:aspects 是介于 domains 与 facets 之间的层级方案;BFAS 是测量该层级的 100 题量表(C-EMP-003)[S4]。容易混淆的地方在于,“aspects 层级”本身不是量表,而 BFAS 才是量表。
把三者放在大五的层级图里看更清楚:
合起来就是:NEO-PI-R 240 题 → 30 facet;BFI-2 → 15 facet;BFAS 100 题 → 10 aspect。三套工具都属于大五家族,但细分粒度、定义边界和计分方式不同,分数不能仅凭名称直接对齐。所以当你看到“大五有 N 个侧面”时,N 已经在告诉你说话人隐含用的是哪一层、哪一套量表。
回到开头那个场景。两份报告都写“果断”,分数分别是 82 和 58。是不是其中一份更准?单凭两个分数高低判断不了:两份报告是否用了同一量表、同一版本、同一分数类型和同一计分规则尚属未知,“果断”只是中译共享的同一个标签,不能据此假定哪一份更“真实”。
这里要建立一条工作规则:仅凭 facet 的标签,无法确认两份报告里的同名指标是等价的构念(C-MEA-004)。原因是——
第一,标签是命名,不是定义。同一英文 facet 名在不同量表中可能用不同题项组合来操作化。比如 NEO-PI-R 的 Assertiveness 与 BFI-2 的 Assertiveness,名字相同,但题项集合、计分键、构念边界的划法是否一致,必须查证各自手册才能判断。
第二,构念的操作化方式不同。NEO-PI-R 在每个 domain 下测量 6 个 facet,BFI-2 测量 3 个。每个 domain 分为 2 个 aspect,BFAS 用于测量这 10 个 aspects。同样叫"果断"的指标,在不同量表里对应的题项组合、理论边界可能不同;仅靠 facet 的个数不能推断哪一种切法更"宽"、更"窄"或更准确。
第三,因此正确的句式不是断言两者必然不同,而是把未知保持为未知:两者属于不同量表,不能预设同名指标在定义、题项和计分上等价。要确定是否等价,必须查源量表的具体手册与计分键,而不是凭标签下判断。
这条边界对读者同样重要:本文作者不持有 NEO-PI-R、BFI-2、BFAS 任一手册的全文,所有关于结构的描述都基于已核验的二次文献与公开技术报告 [S2, S4, S5, S6];手册正文未直接访问的部分保留为书目级引用 [S3]。
先说明:这里的 82 与 58 是纯示意数字,不来自真实个体,也不代表统一量尺。也就是说,它俩不落在同一把尺子上,把它们放一起比大小本身就没有意义。
为什么会这样?因为同一个标签“果断”在两份报告里可能:分别来自 BFI-2 的 15 facet 之一、或 NEO-PI-R 的 30 facet 之一;分别用的是 1—5 的 Likert 均分、T 分、百分位、或自定义标准分;分别落在不同的常模样本上,参照点也不同。
直接把 82 和 58 摆在一起比,等于默认了两件未经核实的事:两份分数用的是同一把尺子;两份分数的“果断”指向同一个构念。这两件默认都站不住脚。
在比较之前,先确认分数类型。原始分、均分、标准分和百分位不能混为一谈;只有知道量尺、计分方式及参照信息,数字才可解释。比如一份给的是 T 分(M=50, SD=10),另一份给的是百分位,两个数字即使相同,含义也完全不同;两份都标“82”,一个可能是 T 分 82(远高于平均),另一个可能是百分位 82(具体含义依赖参照群体与常模信息,不能脱离常模直接解读),两者之间的换算不直接、也不一定有公开对照表。
不同量表、分数类型或施测条件都可能造成结果不可直接比较;在信息不足时,不判断具体原因。
如果你确实想在两份报告之间做有意义的对照,可以走一个简单但稳的三步框架。这同样是“测量—解释—行动—复盘”里“解释”环节的起手式。
第一步:确认量表。 先看报告脚注或附录里有没有写明用的是哪一套量表——NEO-PI-R、BFI-2、BFAS 还是其他。如果只写“基于大五模型”而没有给出具体量表名和版本号,你就处在一个不确定的起点,连“30 个侧面”还是“15 个侧面”都不知道,后续比较更无从谈起。
第二步:读定义。 找到目标 facet 在该量表里的官方定义或题项集合说明。比如同样是“Assertiveness”,要查的是它在该量表里具体测量的是什么——是行为的主动发起,还是意见的表达强度,还是两者混合。读定义时尤其要看构念在该量表里的覆盖范围:不同量表、分数类型或施测条件都可能造成结果不可直接比较;在信息不足时,不判断具体原因。
第三步:比较构念。 在两份报告分别走完前两步之后,才能进入第三步:判断两个“果断”是不是同一个构念。如果两份用的是同一量表、同一版本、同一分数类型和同一计分规则,这只是建立基本可比性的必要条件之一,并不足以单独证明真实变化或个体差异;如果缺少经过核验的等值、转换或关联证据,跨量表同名指标只能作定性阅读,不能计算差距,也不能自行生成相似度。
这三步不是要把简单的对比变得复杂,而是要避免被一个共享标签带进虚假精确的对比里。
FermatMind Unknown。 费马测试(FermatMind)报告里所用的具体量表名称、版本、题项集合、计分键、常模信息,本文作者未直接确认,因此对费马测试报告中具体 facet 分数的测量学属性标注为 Unknown(C-BND-008)。这意味着:本文不能告诉你费马测试报告里的“果断”分数到底是 NEO-PI-R 的、BFI-2 的、还是别的来源。
教育性自我反思。 本文是教育性、自我反思性的内容(C-BND-009)。它不构成临床诊断、心理健康评估、职业决策或招聘筛选的依据。如果你需要这些用途,请寻求具备相应资质的专业人士与正式授权的测评工具。
下一步该做什么。 如果你刚拿到一份大五报告,先用本文的“三步对齐”框架回看自己的报告:确认量表、读定义、比较构念。如果报告里没有写明量表与版本,不妨直接向出具报告的平台询问。这种“先问量表、再看分数”的习惯,本身就是“测量—解释—行动—复盘”里复盘环节的一部分。如果想从更宏观的视角理解大五模型,可以回看大五人格总览与大五主题索引。
如果你想继续进行教育性的自我观察,可以体验费马测试的大五人格测验;完成后仍应以报告实际披露的信息为准,未披露的量表、版本、计分和常模信息保持 Unknown。
Q1:NEO-PI-R 的 30 个侧面具体有哪些? 按 5 个 domain 分组,每个 domain 6 个 facet。神经质:Anxiety、Angry Hostility、Depression、Self-Consciousness、Impulsiveness、Vulnerability;外向性:Warmth、Gregariousness、Assertiveness、Activity、Excitement-Seeking、Positive Emotions;开放性:Fantasy、Aesthetics、Feelings、Actions、Ideas、Values;宜人性:Trust、Straightforwardness、Altruism、Compliance、Modesty、Tender-Mindedness;尽责性:Competence、Order、Dutifulness、Achievement Striving、Self-Discipline、Deliberation。共 30 个,按 IPIP NEO Facets Table 核验 [S6]。
Q2:BFAS 是不是第三套大五量表? BFAS 本身是一套 100 题量表,用于测量 10 个 aspects;aspects 才是介于 domains 与 facets 之间的层级。它与 NEO-PI-R、BFI-2 的细分方式不同,三者分数不能仅凭名称直接对齐。
Q3:30 侧面是所有大五测试的标准吗? 不是。30 个 facet 是 NEO-PI-R 的结构(240 题、每域 6 个)[S5]。BFI-2 用的是 15 个 facet,每维度 3 个 [S2]。把 30 当成“大五标配”会让人误判其他大五工具的结构。
Q4:两份报告都写“果断”,能直接比吗? 仅凭标签无法确认等价。需要核对两份报告分别用的是哪一套量表、该量表里“果断”的官方定义、题项集合和计分方式;即使在同一量表、同一版本、同一分数类型和同一计分规则下,也只构成基本可比性的必要条件之一,并不足以单独证明真实变化或个体差异。分数类型也要先确认——原始分、均分、标准分和百分位不能混为一谈。
Q5:BFI-2 的侧面数和 NEO-PI-R 差很多吗? BFI-2 用 15 个 facet,每维度 3 个;NEO-PI-R 用 30 个 facet,每维度 6 个 [S2, S5]。两者同名 facet 是否指向同一构念需查各自定义;不同量表、分数类型或施测条件都可能造成结果不可直接比较,在信息不足时,不判断具体原因。
Q6:FermatMind 报告里的侧面能等同于 NEO-PI-R 吗? 不能默认等同。费马测试(FermatMind)报告所使用的具体量表名称、版本与计分键本文未直接确认,对相关测量学属性标注为 Unknown。要判断是否等同,需以费马测试报告中实际披露的量表信息为准,再走“确认量表 → 读定义 → 比较构念”三步。
Q7:本文能用于诊断或职业决策吗? 不能。本文为教育性、自我反思性内容,不构成临床诊断、心理健康评估、职业决策或招聘筛选的依据。如需这些用途,请寻求具备相应资质的专业人士与正式授权的测评工具。