

大五人格反馈为什么是「假设」而非「诊断」
大五人格测试反馈不是对你的「诊断」,可以作为关于行为倾向的待核对线索。描述在人群中的相对位置,需要明确的比较样本和换算规则;原始分也可按工具明示的计分与解释规则理解,不能仅凭一个数字推定百分位或常模高低。本文的观察步骤是编辑建议,不是已经验证有效的干预或个人诊断。分数与常模术语
为什么大五反馈是「假设」
大五人格测试得分描述的是你在五个维度上的自评倾向,而不是一种固定的「人格类型」。这里有几个关键原因:
正在准备内容……
大五反馈可以提供待核对的行为倾向线索,不是诊断。区分原始分、标准分与百分位,并用具体生活记录检查描述;个人观察不等于量表或产品验证。
订阅中文博客(Atom) · 将链接添加到支持 Atom 的 RSS 阅读器,接收最新公开文章和实质更新。
大五人格测试反馈不是对你的「诊断」,可以作为关于行为倾向的待核对线索。描述在人群中的相对位置,需要明确的比较样本和换算规则;原始分也可按工具明示的计分与解释规则理解,不能仅凭一个数字推定百分位或常模高低。本文的观察步骤是编辑建议,不是已经验证有效的干预或个人诊断。分数与常模术语
大五人格测试得分描述的是你在五个维度上的自评倾向,而不是一种固定的「人格类型」。这里有几个关键原因:
内容分类
人格心理学
相关标签
大五人格、Big Five、Personality Test
作答有情境边界。 自评问卷按题目要求汇总你对自身行为的描述,不能把一个分数当作所有情境中的直接行为记录。工作和家庭中的表现可以不同;具体分数是否代表平均水平、如何汇总,仍需看该工具的题目、计分和解释规则。
测试测量的是自评报告,不是直接观察全部行为。 指定问卷研究讨论了社会期许相关因素(Bäckström et al., 2009)和诱发情绪对自评分数的影响(Querengässer & Schindler, 2014)。这些发现属于各自工具、样本与研究条件,不能保证某个人在某种情绪下分数一定变化,也不能说明费马产品的变化幅度。
分数本身不是定点。 Anusic 和 Schimmack(2016)使用元分析稳定性与变化模型(MASC)将人格特质的可靠变异分解为:约 83% 归因于稳定影响(stable influences),约 17% 归因于随时间变化的影响(change influences)。这告诉我们人格既有稳定性也有可塑性——但不能据此推断单次测试的「正常波动幅度」,也不能直接用于设定具体的重测间隔。
理解大五分数之前,必须先分清三种不同性质的分数类型——它们经常被混为一谈,但含义完全不同:
原始分是按工具规定直接汇总作答得到的分数,例如平均分或总分。它可以按该工具明确的量尺和解释规则描述作答结果;没有指定的参照样本与转换规则时,不能由它推得人群百分位。
标准分(如 T 分数、z 分数)是将原始分经过统计转换后得到的标准化分数。例如 T 分数通常以 50 为均值、10 为标准差。一个 T 分数 60 意味着你在该维度上的得分比常模均值高 1 个标准差——这不等于「你是第 60 百分位」。T 分数 60 大约对应第 84 百分位左右(假设正态分布)。
百分位告诉你的是在常模人群中,有多少百分比的人得分低于你。百分位 60 意味着你比常模中约 60% 的人在该维度上得分更高。标准分与百分位的对应需要明确的参照分布、转换方法和并列分处理;不能脱离这些条件通用换算。
一个常见的理解错误是看到「得分 60」就以为「比 60% 的人高」——但如果这个 60 是采用均值50、标准差10的 T 分数,且参照分布为正态,才近似对应第84百分位;如果 60 本身就是百分位,那才是比 60% 的人高。看报告时先确认你的分数是哪种类型,不要自己推断。
当我们面对人格测试反馈时,很少能做到完全中立。以下研究提供了理解反馈接受的线索,并不能解释每个人的反应:
Barnum/Forer 效应。 Dickson 和 Kelly(1985)的综述摘要讨论了人们接受模糊、笼统人格描述的倾向,以及描述的表面相关性和正向程度与接受度的关系。Furnham 和 Schofield(1987)也综述了反馈接受问题。觉得反馈「很准」时,可以检查它是否提供了可观察、可反驳的具体信息;这种检查本身不验证一个产品。
自我验证动机。 Swann 等人(1992)的研究讨论了指定样本在选择评价者时如何考虑既有自我认识,包括负面自我认识。这是特定研究条件下的发现,不能推定每个读者对任何报告的第一反应。你可以把「这是否符合我的既有叙事」作为观察问题,而不是预先替自己作心理判断。
反馈的正向偏误。 Barnum 效应综述讨论了正向程度与反馈接受的关系。不能据此断言某个读者会如何接受某一维度的结果,这些群体研究不能预先决定你的个人反应。
报告和你的自我感受不一致,不一定说明报告错了,也不一定说明你的自我认知错了。可能的原因包括:
作答状态的影响。 Querengässer 和 Schindler(2014)在98名德国参与者中比较诱发情绪前后的自评。摘要报告悲伤条件下神经质升高、外向性下降,并报告幸福条件下外向性升高的趋势;这些结果不能直接推定某个读者、其他工具或真实压力事件的影响。解释分数时可记录作答背景,而不把背景自动当作差异原因。
自我认知的盲区。 Bollich 等人(2011)的 Hypothesis & Theory 文章综述了自我与他人了解人格的相关实证研究,同时提出反馈可能促进自我认识的路径。特定反馈干预是否有效仍需要相应证据。朋友的观察可提供另一个视角,但不自动成为更准确的判决。
常模参照的影响。 百分位取决于比较群体和转换规则。假设同一分数在两个群体中的相对位置不同,这属于说明常模作用的假设例子,不是大学生与销售从业者的实测比较。
社会期许效应。 Bäckström 等人(2009)研究了指定五因素问卷中与社会期许相关的一般因子和条目中性措辞。它不能证明如实作答必然提高任何个人产品分数的准确性。按实际经验回答是一条作答建议,产品准确性仍需工具和用途对应的验证。
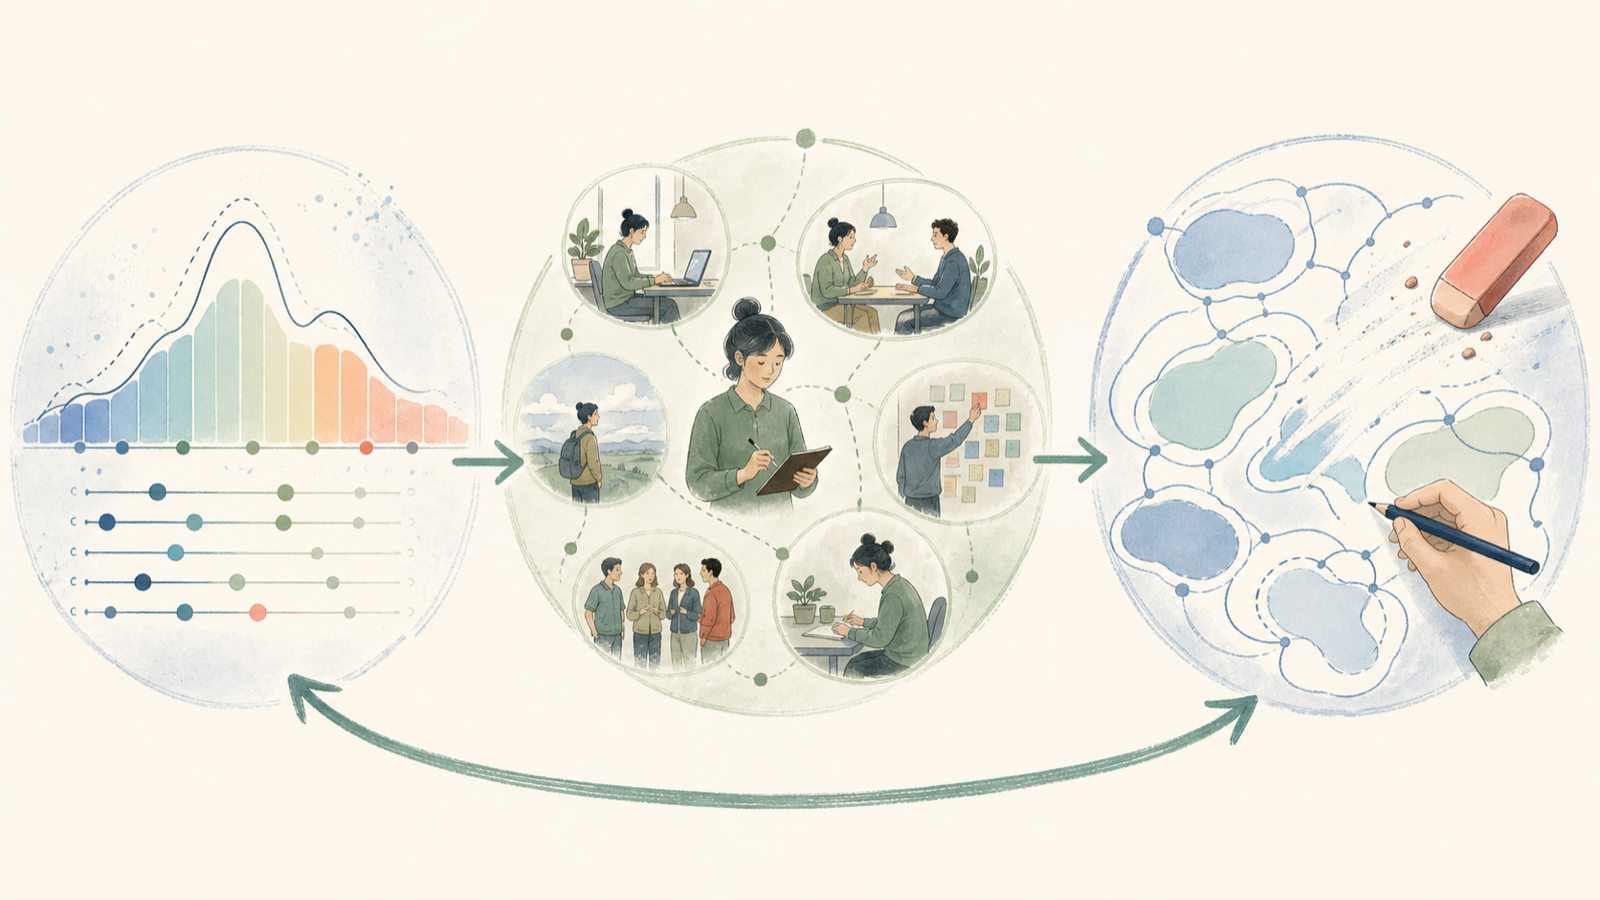
可以把报告中的具体描述当作待核对的观察问题。下面三步用于整理生活记录,不是统计假设检验,也不能自行验证量表效度、常模或个人预测准确性:
第 1 步:把分数翻译成可检验的具体陈述。 当看到「宜人性:偏低」时,不要直接接受标签。可以提出一个情境化的观察问题:「我在意见分歧时是否更倾向于坚持自己观点而非寻求共识?哪些情境有相关记录,哪些有反例?这个问题是阅读时构造的例子,不能仅凭一个低分认为报告已验证该行为。」
第 2 步:在现实生活中主动收集证据。 观察自己接下来两到三周在相关情境中的实际行为,做简单记录。注意支持和不支持该观察问题的记录。邀请信任的朋友提供具体情境中的观察——自评和他评各自捕捉到不同侧面的信息,具体情境中的一致与分歧都可作为进一步探索的线索;朋友与自评可能有共同偏差,一致本身不能证明结论正确。
第 3 步:修正理解,迭代。 如果日常观察大量支持假设,它可以成为你自我认识的一部分。如果发现大量反例(比如在一个虚构例子中,报告说你低尽责性但你连续几个月都按时完成了重要项目),调整你的理解。后续在类似情境下重新观察相关行为,不一定需要立即重测。
当分数和你在多个重要生活领域中的实际行为严重不符时。 如果你在工作、家庭、社交等情境中的记录与报告描述矛盾,核对描述范围、作答条件、记忆偏差和具体事例。生活观察和测验各有局限,不能预先认定任何一方必然更准确。
当测试是在高压或情绪低落时做的。 可记录这一作答背景。指定情绪诱发研究不能证明每次压力都会造成同一种自评分数变化,也不能说明你的分数更多反映状态还是特质。
当工具与用途的证据不清楚时。 核对量表版本、计分方法以及对应语言、样本和用途的信效度证据。如果报告声称给出人群百分位或常模高低,还需核对比较样本与转换规则。不能仅凭没有公开常模就断定工具质量差;BFI-2 作者网站说明没有附带公开常模的官方手册,这也不等于它支持任何产品自设的百分位。
当分数的呈现方式不透明时。 先核对它是原始分、标准分还是百分位,以及对应解释规则。原始分的描述未必需要常模;人群相对位置的说法则需要明确的参照依据。信息不足时保留不确定性,不自行补出高低排名。
边界说明: 本文用于教育和有限自我观察,不能替代专业评估或用于单独作出人事决定。它没有提供足以核验费马测试具体版本的信效度、常模、个体预测或反馈干预效果的产品证据;这些产品证据仍需另行核验。工具、版本与计分说明须另行查阅对应的权威资料。
Q1:大五分数会不会变?
可能变化。Roberts 等人(2006)基于92个样本的元分析报告群体平均特质随年龄变化,例如成年期尽责性与情绪稳定性的上升趋势。这不保证某个人必然变化,也不能据此预测个人的方向、幅度或一次产品重测的差异。
Q2:高/低分数是不是好/坏?
不是。大五各维度没有绝对的「好」或「坏」标准。分数的意义取决于具体情境——同一个特质在不同环境中可能带来不同的适应结果。不能仅凭维度高低判断一个人的价值、适应性或未来结果。
Q3:为什么我测试两次结果不同?
不应仅凭两次差异判断哪次更真实。Anusic 和 Schimmack(2016)使用 MASC 模型将人格特质的可靠变异分解为约 83% 稳定影响和约 17% 变化影响,说明人格兼具稳定性与可塑性,但该模型不直接提供特定测试间隔的波动量。如果差异很大,检查测试条件是否一致——情绪状态、作答环境、使用的量表版本是否相同。
Q4:朋友说的和报告不一样,该信谁?
两者都可以作为观察线索,也都有局限。Bollich 等人(2011)既综述了自我与他人知识的实证研究,也提出反馈路径;这些研究不能证明本文的反馈步骤已经有效。比较具体情境中的信息,一致或分歧都可以提示下一步观察,不能自动决定哪一方正确。
Q5:报告说我高神经质,是不是我有问题?
人格维度分数本身不是精神疾病诊断,也不能判断你是否需要哪种服务。本文不根据分数、某个阈值或持续时间作健康评估;若你对健康或安全有担忧,寻求合适的专业支持,不必等待一个人格结果作判定。
Q6:怎么判断一个测验靠不靠谱?
先确认工具名称、版本、题目来源、计分与分数类型,再查对应语言、样本和使用目的的信效度研究。有论文或写着「大五」不自动证明某个产品已经验证;如果提供百分位,核对比较群体与换算方法。原始分工具没有公开常模,也不能单独作为质量否定依据。
Q7:本文能用于诊断或招聘吗?
不能。本文内容仅用于教育目的——帮助读者理解人格测试反馈的性质和局限性。它不能替代专业心理评估或临床诊断,也不应用于人事选拔或任何高利害决策。如果你对自己的心理健康有担忧,请咨询有执照的心理健康专业人士。
想继续了解大五分数与反思的边界吗?
本文中的三步观察及两到三周记录窗口是可调整的编辑建议,不是由上述研究确立的疗程、重测间隔或产品有效性证据。