情商测试准吗:EQ-60四维自评与科学边界 | FermatMind是在测会不会说话,还是在看情绪管理
?
它能怎样帮助理解反复发生的人际摩擦
?
这篇文章适合做过EQ测试却不知道怎么解释、想改善沟通又不想被成功学误导,以及正在比较不同测量方法的人。它说明本站工具如何组织自我描述,以及哪些结论仍需要额外证据。
先把问题问准:你想测的是“情商高低”,还是情绪习惯?
一个人在公开表达时很稳,但在亲密关系里容易防御;一个人在冲突里能体面说话,但很难识别自己的压力信号;一个人能体谅别人,却不会给自己留恢复空间。这些都不能由一句“情商高低”解释清楚。
更具体的问题是:我能否及时察觉情绪变化?遇到压力时怎样反应?能否区分事实、感受和推测?理解他人的反馈后,是否还能表达自己的需要?误解发生后,怎样修复沟通?
把这些问题拆成可观察、可复盘的线索,比给自己定一个标签更有用。
为什么本站采用自评?它与能力测验有什么区别?
自评适合本工具的任务:询问你认为自己通常怎样识别情绪、回应压力、理解他人和处理关系,再把回答整理成结构化的反思入口。许多内在感受并不能只靠旁观者看见,自我描述可以提供一个视角。
这个视角有明显限制。你可能按理想中的自己作答,只想到最近一次争执,或在不同关系中有完全不同的表现。回答因此反映自我认识、题意理解和当前情境,而不只是一个稳定的能力。
能力型测验则要求完成情绪相关任务,并依据该工具的规则评价表现。2025年MSCEIT 2原研究讨论了任务设计、专家计分、因素结构和测量限制。它与旧MSCEIT V2.0是不同版本;研究中的能力任务与EQ-60自评不能直接等同,也不能把该工具的信效度移给本站。
怎样作答,怎样理解质量提示?
当前为60题、约10分钟,以1–5分五点自评作答。尽量按通常真实行为选择;遇到抽象描述时,回想近期具体事件,也检查有没有不同的例子。不要为了表现成熟而选择理想答案。
后端先统一正反向题,再汇总四维。质量检查关注用时、连续相同选择、极端/中间选择比例及成对题目一致性。这些是谨慎解释的提示,不是“诚实检测”,也不等于量表信度或效度。若报告提示低置信度,先检查作答条件与题意,不急着认领强烈的个人画像或练习重点。
FermatMind当前EQ-60的四个维度
| 维度 | 本次自评整理什么 | 可以继续观察的问题 |
|---|
| SA 自我觉察 | 对情绪、触发点、身体信号和当下需要的识别倾向 | 我什么时候发现自己生气?发现后能否说清需要? |
| ER 情绪调节 | 压力、反馈、挫败或冲突后暂停、复位和选择回应的倾向 | 我做了什么来调节?当时条件允许吗? |
| EM 共情理解 | 对他人线索、观点和可能感受的理解倾向 | 我的理解有没有向对方确认? |
| RM 关系管理 | 表达、协作、边界和关系修复的倾向 | 请求是否清楚?责任和下一步有没有达成一致? |
这些维度不是“好人/坏人”“成熟/幼稚”“成功/失败”的标签。EM较高也不能证明你猜对了别人的感受,RM较高不能直接预测关系质量或领导力。当前四维是组织报告的框架,其因素结构仍需要实证验证。
压力恢复涉及冲突后怎样休息、调节和恢复行动,也可能与负荷、睡眠、支持和工作安排有关。它可放在ER、RM等情境中讨论,不能另加一个“恢复分”。
“准不准”需要哪些证据?本站目前到哪里?
| 证据问题 | EQ-60当前状态 | 对读者意味着什么 |
|---|
| 题目与解释覆盖什么 | 内容证据尚初步 | 支持组织自评主题与解释边界,不证明客观能力 |
| 同维题目是否一致 | 内部一致性验证计划 | 不能宣称已有完整的分维信度结果 |
| 相近条件下是否稳定 | 重测稳定性验证计划 | 一次分数不应被当成永久标签 |
| 题目是否支持四维结构 | 结构验证计划 | 四维解释框架不等于已完成因素验证 |
| 与外部行为如何关联 | 外部关联验证计划 | 不能预测工作、关系或健康结果 |
| 两语与群体含义是否相同 | 等值验证计划 | 不直接把跨语言差异当能力差异 |
| 参照对象是谁 | 阶段性参照 | 标准分和百分位须结合实际版本、来源与状态读 |
后续验证需要按语言、版本和适用人群收集足够资料,检查题意与维度归属,估计适当的内部一致性指标,观察重测,进行探索/验证性结构分析,并检查项目差异及低风险外部指标。这里是当前验证计划的解释,不是已经完成的结果或完成日期承诺。
EQ分数怎么看:保留数字,再回到场景
反向题先转换:正向y=x,反向y=6−x。某道反向题选2,计入的是4。每维15题的原始和S范围15–75,均分=S÷15,POMP=100×(S−15)÷60。
合成演算:某维度原始和60,均分4,POMP75。75表示这个自评量尺上的位置,不表示超过75%的人。总原始和G范围60–300,总POMP=100×(G−60)÷240。
标准分另依赖参照:z=(S−μ)÷σ,标准分=100+15z,限制在55–145;整体标准分对四维z分的平均值作同样转换。如果实际使用μ=53.5、σ=7.5,S=60得到113。这里的参数是条件示例,不是每份线上报告的已核参数;113不是IQ。
报告中的百分位由100×Φ(z)作标准正态模型换算,不能直接读成经代表性调查得到的人群排名。PROVISIONAL表示阶段性,也不证明参照样本代表所有人。不同工具的相似数字不能直接比较。
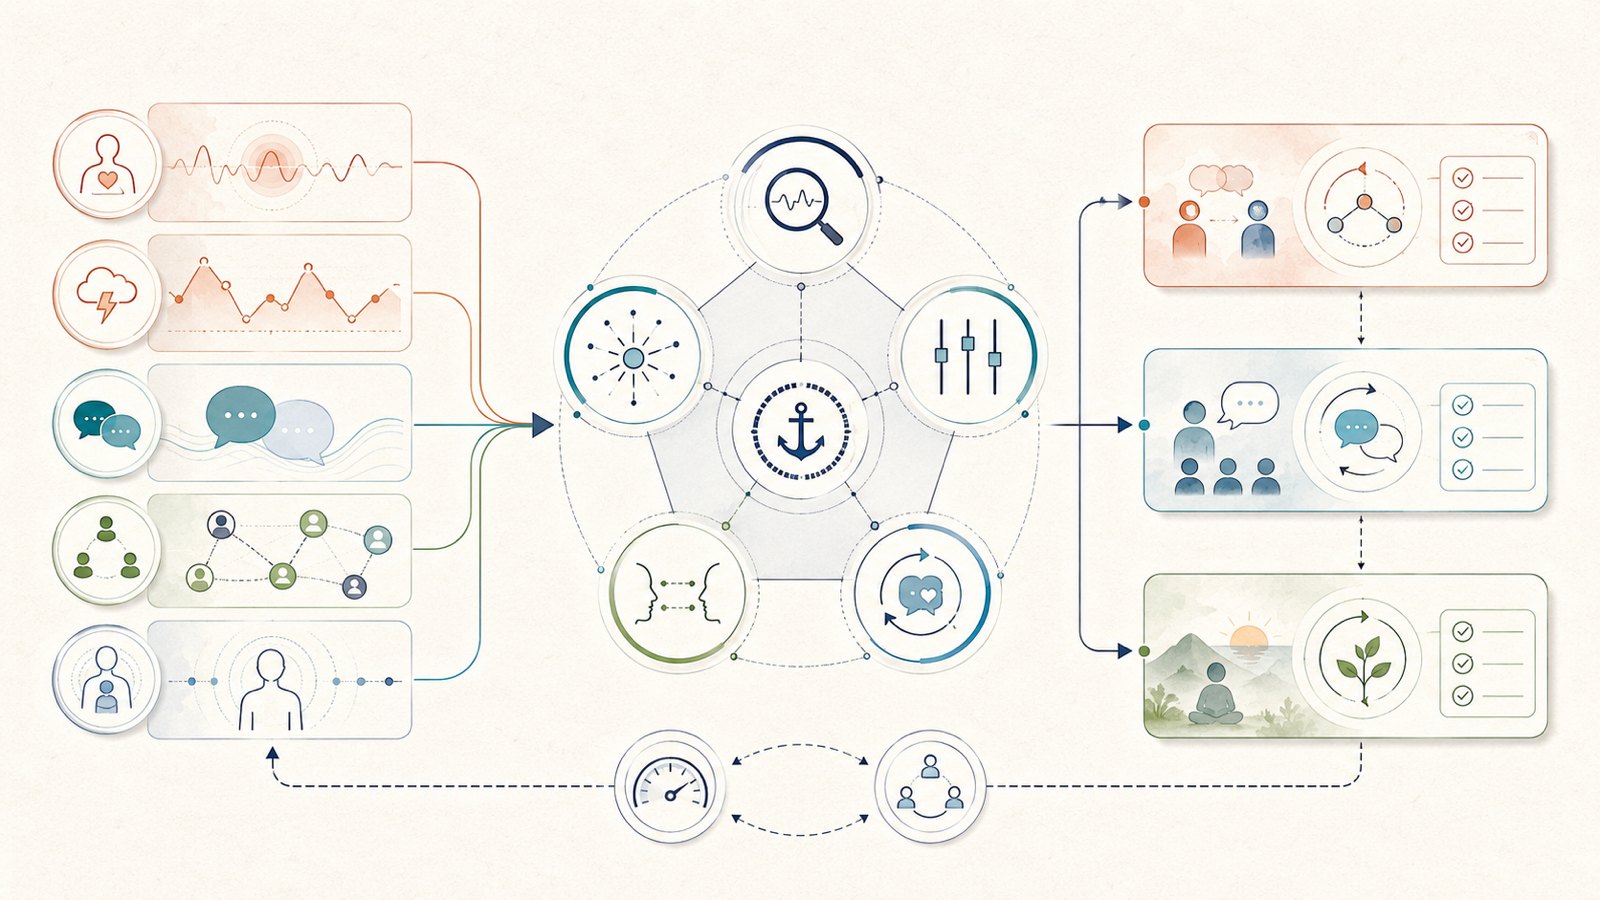
读结果可以分三层:先了解四维本次回答的相对分布,再核对作答质量与参照状态,最后检查现实事件是否支持某个具体问题。若结果与经验不一致,保留差异,检查题意、近期状态、关系和场景;不强迫自己编一个吻合的故事。
情绪调节、关系管理和压力恢复分别是什么意思?
情绪调节不是压住情绪
情绪调节不是永远平静,也不是不生气。你可以识别情绪、承认它存在,再选择怎样回应。例如,同样被批评,有人立刻反击,有人沉默很久,有人先确认对方在说事实、评价还是感受。这些行为还需要结合安全、角色和当时资源理解,不能直接排列道德高低。
Gross与John的2003研究区分重新理解情境的重评和抑制外在表达,包含自评、同伴评价及相关分析。它为区分策略提供研究背景,但样本主要为大学年龄参与者,不能证明某个动作适用于所有文化与情境,也不验证EQ-60。
关系管理不是会说漂亮话
关系管理包括清楚表达需要、倾听担心、处理误解、协作和边界。说话得体但从不表达真实限制,不能据此证明关系管理较好;话不多但能把问题与下一步说清,也可以提供有用的沟通证据。
压力恢复是应用问题,不是第五维
经历冲突或高负荷后,可以检查休息、工作安排、支持和未完成的问题。恢复困难不应自动归因于EQ。若资源一直不足,仅靠调整说话方式也可能无效。
合成案例:自认共情很好,却误解了同事
以下人物与事件为原创合成示例,不是题目、真实用户结果或验证研究。
林遥在自评中较认可“能理解他人”一类描述。一次方案讨论后,同事说“先到这里”,她把它解释成对自己不满,于是连续发送解释。可观察事实只有这句话与会议结束;“他不满”仍是推测。她的焦虑是真实感受,但不能充当对方感受的证据。
她先记录胸口紧、担心被否定,这是SA的观察问题。然后暂停发送长消息,检查还有哪些解释:同事可能赶下一场会,也可能没有足够资料。暂停提供整理信息的机会,不保证情绪立刻消失。
她询问:“刚才结束得比较快,我不确定你是时间不够,还是方案有需要改的地方。方便时能说一下最重要的问题吗?”同事说明自己赶会,并指出一个预算假设。这次反馈支持“时间与具体问题”解释,削弱了“他整体否定我”的推测。她确认修改责任和时间,这是RM的实际行动;不是EM分数证明她猜对了。
反例是上周一次类似会议:她同样担心被否定,却先问了截止时间,顺利继续工作。这个自然发生的例子说明“我总会误解”过于宽泛。它不能证明她没有困难,而是让观察缩小到“结束突然且信息缺失时,我容易把不确定解释为否定”。
如果澄清仍得不到回应,可能是对方繁忙、信息渠道不合适或责任不清。调整为简短书面问题,写明需要确认的事项与期限;无法决定时,请有权限的人明确安排。若存在羞辱、威胁或持续不安全,不要求她继续承担修复任务。
下一步记录类似事件中:事实与推测是否分开、对方是否确认或纠正理解、下一步是否明确。如果没有类似事件,就记“缺少观察机会”,不把没有反例当成假设已成立。主动尝试新做法后的成功,单独记为实践结果,不补作原模式的自然反例。
EQ不是会说话、讨好或圆滑
会说漂亮话不证明能处理情绪和关系;不表达愤怒不证明调节有效;让所有人舒服也可能以牺牲真实边界为代价。情商自评低分不等于心理疾病,高分不证明善良、诚实、领导资格或成功。
工作与关系结果还受到知识、角色、机会、资源、他人行为和环境影响。自评可以帮助提出问题,不能替代这些证据。
EQ与IQ回答什么不同问题?
EQ-60询问你怎样描述自己的情绪和关系倾向;费马当前IQ入口是30题原创矩阵/视觉推理任务,观察这次任务表现。其Beta按预设规则进行展示分数换算,不是代表性人群IQ,也不代表整个人的工作能力。
如果你的问题是“我在关系里哪里卡住”,可以观察EQ相关场景;如果是“我在推理任务中如何验证规则”,就看具体任务与策略。两者都不是人生排名,也不能给出职业适配结论。
结果怎样转成可验证的小行动?
- 选一个具体场景,例如被批评、协作分歧或表达拒绝。
- 从SA、ER、EM、RM中选相关问题,不添加恢复第五维。
- 记录触发事件、当时的解释、感受和可用条件。
- 选择一个微行动,例如澄清一句话、复述担心或说明需要。
- 记录对方实际反馈与下一步,而不只记录自己觉得更稳了。
- 经几次相关事件后复盘:保留有效动作,缩小解释或调整条件。
“暂停片刻”“一周后回看”是方便开始的建议,不是经过EQ-60验证的最佳剂量。复述也可能让人觉得机械;若对方纠正你,应先接受纠正,而不坚持自己很有同理心。结果提示只是选择观察起点,真实反馈决定是否继续。
想把上述步骤落到一次具体对话,可读情绪觉察、调节与关系练习,对照批评、拒绝与误解等合成情境,记录实际反馈。这些练习是可尝试的编辑建议,不保证分数或关系改善。
什么时候适合用自评,什么时候需要其他方法?
想把模糊的情绪体验拆成具体问题、自愿复盘沟通,或尝试低风险行为时,可以把EQ-60作为入口。若需要证明任务能力,应考虑实际任务、行为观察和符合用途的工具;若要作临床、教育或其他高风险判断,应使用相应专业评估。
持续困扰影响睡眠、工作、人际安全或日常功能时,寻求合格专业人士或现实支持。在线自评不替代危机处置。EQ-SJT-16目前是计划中的情境判断模块,没有开放参加入口,也没有已完成验证或整合报告的承诺。
常见问题
情商测试准吗?
必须看具体工具和用途。EQ-60的内容证据尚初步,信度、结构、重测、外部关联及等值验证仍列为计划,不能称为已经全面验证的能力测试。它适合组织自我描述,帮助提出现实观察问题。
EQ-60到底有几个维度?
只有SA自我觉察、ER情绪调节、EM共情理解、RM关系管理,四维各15题,共60题。压力恢复是应用情境,不是第五维。
为什么用自评,不直接测真实能力?
本站希望整理你对日常情绪与关系行为的认识。自评能提供内在体验视角,但会受认识、题意和情境影响。能力型任务评价的是任务表现,两者不能直接替换。
POMP75和标准分113分别是什么意思?
单维原始和60可换算为POMP75;只有实际采用μ=53.5、σ=7.5时,本例标准分为113。POMP75不是第75百分位,113不是IQ。查看具体报告的参照状态和版本。
共情分数较高,就能知道别人真实感受吗?
不能。它反映你如何自我描述。把理解写成可纠正的猜测,并向对方确认;对方的纠正比“我共情高”的标签更有用。
情商等于会说话吗?
不等于。表达流畅与识别情绪、选择回应、尊重边界和修复误解是不同问题。观察实际过程与结果,不用谈吐定情商。
EQ与IQ能直接比较吗?
不能。EQ-60自评与费马原创推理任务的测量方法和参照不同。相似的标准分尺度也不表示相同能力或可换算分数。
情商能提高吗?
可以选择具体行为作练习目标,但本测试不保证效果。检查真实沟通是否更清楚、责任是否更明确;短期自评分数提高不能单独证明能力增长。
可以用于招聘、岗位选择或诊断吗?
EQ-60不能用于这些高风险判断,也不能判断他人是否适合岗位。职业探索需要兴趣、技能、工作样本、资源与机会;临床问题需要合适专业评估。
如果问题是人格与沟通偏好,可继续阅读既有MBTI工具指南;如果关注较长期的行为特质描述,可看大五人格工具指南。它们回答不同问题,不证明情绪能力,也不替EQ-60提供验证。
下一步