一个醒目的数字,可能还缺少关键信息 同样写着“42”的两份报告,含义未必相同。这个数字可能是题目得分的汇总,也可能是某种转换后的分数,或是相对于某个比较群体的位置。没有量尺和参照,它不能自行推出“我比别人差”“我不适合管理”或“我必须改变”。
大五研究提供的是理解人格差异的一种广义结构框架,不是一张给个人盖章的身份证。Goldberg(1990)在以特质词为材料的因子分析样本中报告了五因素结构的概括性。这可以解释为什么许多工具使用大五语言 ; 但它不等于每一份在线报告都测量相同内容,也不等于一份报告能够替人回答工作、关系或人生选择。
如果两份报告给出不一样的结果,先不必争论哪一份“更准”。更值得核对的是 : 是否为同一工具或版本、分数是否以同一种方式呈现、比较依据是否相同,以及作答时的情境是否相近。信息不足时,合适的标记是“待核实”,不是立刻用数字定义自己。
测试前 : 把焦虑改写成能观察的问题 “我到底适不适合这份工作 ? ”范围太大,很容易让报告变成裁决。可以把它改成 : “当意见相反时,我通常怎样表达不同意见 ? 下一次评审里我想留意什么 ? ”前一个问题要求确定的命运答案,后一个问题把注意力放回行为和情境。
开始前,写下两栏 : 这一轮测试想帮助你观察什么,以及它明确不能替你决定什么。例如,前一栏可以是“我在高压会议中更容易沉默,还是更容易抢话” ; 后一栏可以是“这份结果不决定我是否胜任岗位,也不交给他人用作筛选”。
这类划分符合测试使用中的基本谨慎原则。ITC 的《测试使用指南》强调,测试解释和使用应有与预定用途相符的证据,也应避免由一项测试过度概括未测量的人的特征。先写清用途,能让边界在看到分数之前就已经存在。
作答时 : 如实回答,也把当时情境记下来 先看题目问的是什么范围。若它问的是日常倾向,回答时可以参照几个普通而具体的场景,而不是只抓住某次特别顺利或特别难受的经历。若题目已经说明时间或情境,就按它的说明理解 ; 若没有说明,也不必把一次极端经历当成全部生活。
不需要为了得到“好看”的结果而挑答案。报告中的高低描述本身不构成一张普遍的优劣表。比如,外向性的一个分数不能单独判断一个人是否适合带项目 ; 要讨论项目表现,仍须回到任务要求、支持条件和实际行为。
如果作答时正被催促、非常疲惫、刚经历冲突或处于其他不寻常状态,把这一点记下来即可。这样做不是要追求某个“完美分数”,而是避免日后把一个特殊时点误作长期结论。
读报告后,先做一次“报告审计” 读报告的第一步不是解释性格,而是把已知、未知与不适合使用的范围分开。下面这张审计卡不认证任何工具 ; 它只帮助你看见信息缺口。
要核对的项目 要找的说明 找不到时的处理 工具与版本 是否说明具体量表或版本 标为“待核实”,不与其他报告直接换算 分数类型 原始分、转换分、百分位或其他量尺 不把数字当作通用的高低判断 比较依据 是否说明比较群体、时间或适用范围 不推断自己“超过多少人”或处于什么层级 作答情境 当时是否被催促、疲惫或遇到特殊事件 把情境列为解释限制 本次用途 是个人反思,还是会影响他人权益 涉及录用、录取、医疗等高影响用途时,不让这一份报告单独决定
ITC 指南提出,解释分数时需要留意量表、比较组、技术限制和施测情境,并避免过度概括。AERA、APA 与 NCME 的《教育与心理测验标准》则区分了两种不同的解释 : 描述当前特征,与预测未来结果。二者需要分别针对预定用途的证据。因此,“报告似乎描述了我的某种倾向”不能自动变成“报告能预测我会不会成功”。
审计卡也能告诉你何时先停下来。例如,一份报告显示百分位却没有说明比较群体或分数来历,你可以承认这个标签让你有所共鸣,但不应把它当作精确排名。即使说明较多,也仍要追问 : 它支持的用途,是否就是我现在想解决的问题 ? 排版完整并不会自动让一份一般自我描述变成岗位表现、亲密关系或健康状态的判断。
如果报告使用“较高/中间/较低”,可继续读 大五人格分数区间怎样理解 ,核对区间、量尺与比较依据 ; 缺少适用参照时,不把标签换成人群排名或能力等级。
对小林而言,更稳妥的一句话或许是 : “这份报告提醒我观察自己在会议中的参与方式 ; 但我还不知道 42 的比较依据,也不能凭它判断我是否适合带项目。”这已经足够成为一次反思或沟通的起点。
审计时,不需要把每一个空白都补成结论。可以在报告旁边直接写下三类标记 : “已说明”“待核实”“本次不使用”。例如,工具名称已经写明,就记入第一类 ; 比较群体没有说明,就记入第二类 ; 若你正考虑把结果用于评价他人,就先放进第三类。这样做的价值不在于把报告变得更权威,而在于不让一个信息不完整的数字越过它原本能承担的范围。
如果随后拿到了更多说明,也不必追求把所有信息合并成一个总判断。先只问新信息解决了哪个具体缺口 : 它解释了分数的量尺,还是解释了比较依据,还是说明了可支持的用途 ? 每补上一项,结论都只在相应范围内更新。保留这种逐项更新的习惯,比在信息不足时用一句笼统的“有效”或“没用”更有助于保持判断清楚。
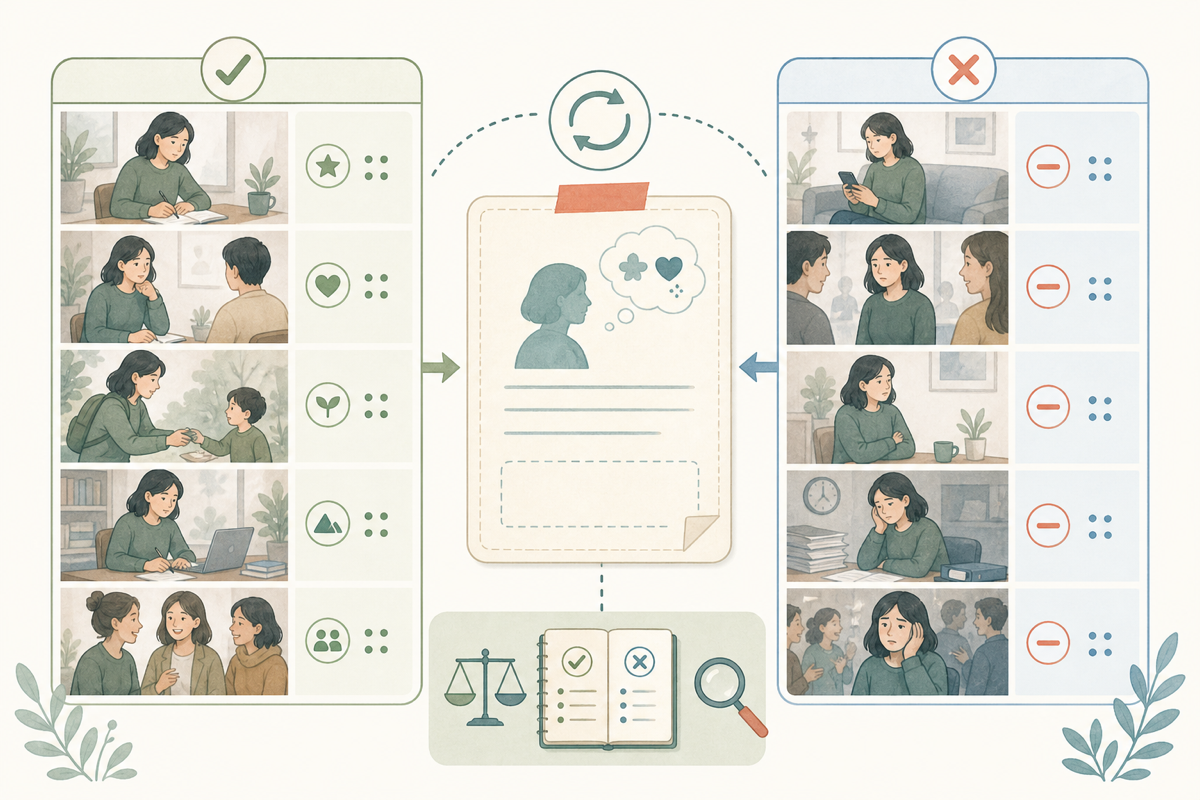
把标签变成七天观察,而不是人格判决 假设报告将小林描述为“外向性偏低”。她不必因此退出项目主持的候选名单。她可以只挑一个低风险场景 : 接下来三次项目会,在会前写下一句准备提出的问题 ; 会后记录是否提出、当时发生了什么,以及有没有反例。
吻合的观察 不吻合或需要更多解释的观察 面对不熟悉的客户时,开场前会准备更久 与熟悉团队讨论技术方案时,能主动追问并总结 被临时点名时容易缩短回答 有明确议程和轮次时,愿意承担主持
七天后,得到的不是“我就是内向”,而是更具体的问题 : 陌生关系、临场压力、会议结构和准备时间,哪一项正在影响参与 ? 下一步可以尝试一个可逆的小调整,例如提前取得议程、先写一条问题,或请同事预留发言轮次。若没有帮助,就停止这项尝试或换一个假设。
这是一种低风险的自我反思方法,不要求你相信报告完全正确。相反,它把报告当成有待观察的提示。若连续记录都不吻合,无须勉强解释为自己“答错了” ; 也可能是描述不贴合这个情境,或最初的问题问得太粗。主动保留反例,才能让观察不沦为给标签找证据。
同属大五框架,也不代表工具可以互换 工具之间可能在题项数量、维度粒度、计分、施测语境和信息披露上不同。Soto 与 John(2017)对 BFI-2 的研究提供了一个具体例子 : 该系列的完整版本为 60 项,另有 30 项简式和 15 项极简式 ; 在该研究范围内,15 项的 BFI-2-XS 不应用于侧面特质。
这个例子只说明,同一框架中也会有不同设计和解释边界。它不能推广为所有短测试的结论,更不能证明“题越多越准确”、收费工具一定优于免费工具,或未披露技术资料的报告具有某种品质。
选择或使用工具时,可以先看它是否说明用途、版本、分数解释方式,以及是否提供可审查的技术资料。资料不足,不必急着给工具贴上“无效”的标签 ; 更合理的做法是缩小使用范围,把它留在个人反思,而不将其用于筛选、诊断、录用、升学、财务或法律决定。
别让一份报告代替真实对话 “宜人性较低”不适合直接成为对同事的解释。如果你想改善一次意见冲突,可以把标签改写成一句可讨论的话 : “我倾向先指出风险,但不想跳过你的方案。我们能不能先各自说一条担心和一条可行条件 ? ”这比“我的人格就是这样”更能为对话留出空间。
同样,别人不愿分享结果时,尊重拒绝比追问分数更重要。测试结果不宜成为给伴侣、同事或求职者贴标签的快捷方式。若问题需要专业判断,或已经明显影响日常生活和安全,网络人格内容不能替代相应的专业支持。
FermatMind 产品信息 : 分开看公开说明与验证证据 费马大五测试说明 已公开标准版 120 题、短版 90 题,以及五个维度、30 个侧面和部分计分说明。应先核对你实际使用的题本、报告版本和比较依据,不能把这些已经披露的事项一律写成未知。
公开结构与算法说明不等于已经取得对应的信度、效度或预测用途证据。本文没有据此核实费马题本在特定人群中的测量误差、常模代表性或高影响用途 ; 这些问题仍需对应版本的技术资料。Goldberg、BFI-2 的研究和一般测试使用标准,也不能移植为对费马产品的验证。读报告时,把已说明、待核实和本次不使用的项目分别记下。
五维结果怎么读 维度 先观察什么 不要直接推出什么 开放性 对新观念、变化和复杂信息的兴趣 创造力高低、智力或职业适配 尽责性 计划、持续投入和完成任务的习惯 道德品质、能力或必然绩效 外倾性 社交刺激、表达和活动水平偏好 社交能力、领导力或人缘 宜人性 合作、信任、同理与冲突方式 善恶、服从度或团队价值 负性情绪倾向 压力敏感、担忧和恢复线索 心理诊断、脆弱或未来健康
高低分都不是普遍优劣。选择一个现实场景,同时记录吻合证据、反例和环境条件 ; 如果报告没有说明量表、分数类型或比较群体,就先标记“待核实”。
常见问题
大五人格结果应该先看什么 ? 先看工具与版本、五维名称、分数类型和比较依据,再看每个维度的高低位置。缺少量尺、常模或参照群体时,不要把一个数字直接解释成排名、优劣或能力。
大五人格五个维度的高分和低分代表好坏吗 ? 不代表普遍的好坏。开放性、尽责性、外倾性、宜人性和负性情绪倾向都是连续维度 ; 同一倾向在不同任务、关系和压力环境中可能带来不同优势与代价。
两个维度要不要组合起来看 ? 可以把多个维度放回同一个场景观察,但不要据此发明固定人格类型。例如会议参与可能同时受外倾性、压力、准备时间和团队结构影响,组合解读仍要保留情境与反例。
大五人格结果不同或复测变化怎么办 ? 先核对是否为同一工具、版本、计分方式和比较群体,再记录作答时的疲劳、压力与近期事件。差异可能来自工具、情境或真实变化 ; 在信息不足时标记“待核实”。
大五人格结果可以用于招聘、诊断或职业预测吗 ? 本文不支持这些用途。一次在线结果不能单独用于招聘筛选、医疗或心理诊断、能力判断、录取、职业适配或成功预测 ; 高影响决策需要与用途匹配的独立证据和专业流程。
下一步 如果你想把阅读转成一次结构化自我观察,可以 开始大五人格测试 。结果只用于提出可验证假设,不替代能力、招聘、诊断或未来判断。
参考来源与下一步 Goldberg, L. R. (1990). An alternative “description of personality” : The Big-Five factor structure. Journal of Personality and Social Psychology, 59(6), 1216–1229. DOI : 10.1037/0022-3514.59.6.1216。本文仅用其说明五因素结构研究的范围。 Soto, C. J., & John, O. P. (2017). Short and extra-short forms of the Big Five Inventory–2 : The BFI-2-S and BFI-2-XS. Journal of Research in Personality, 68, 69–81. DOI : 10.1016/j.jrp.2017.02.004。本文仅用其说明特定 BFI-2 系列的短版取舍。 International Test Commission. (2013). ITC Guidelines on Test Use. https : //www.intestcom.org/files/guideline_test_use.pdf American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for Educational and Psychological Testing. https : //www.testingstandards.net/uploads/7/6/6/4/76643089/standards_2014edition.pdf 下一次打开大五报告时,先用审计卡确认这份数字究竟说明了什么、还缺什么,再决定是否值得做一轮小范围观察。信息仍不足时,暂不使用这个分数,也比急着寻找一个更响亮的解释稳妥。
大五人格测试结果怎么看?五维分数、使用方法与边界 | FermatMind