快速答案
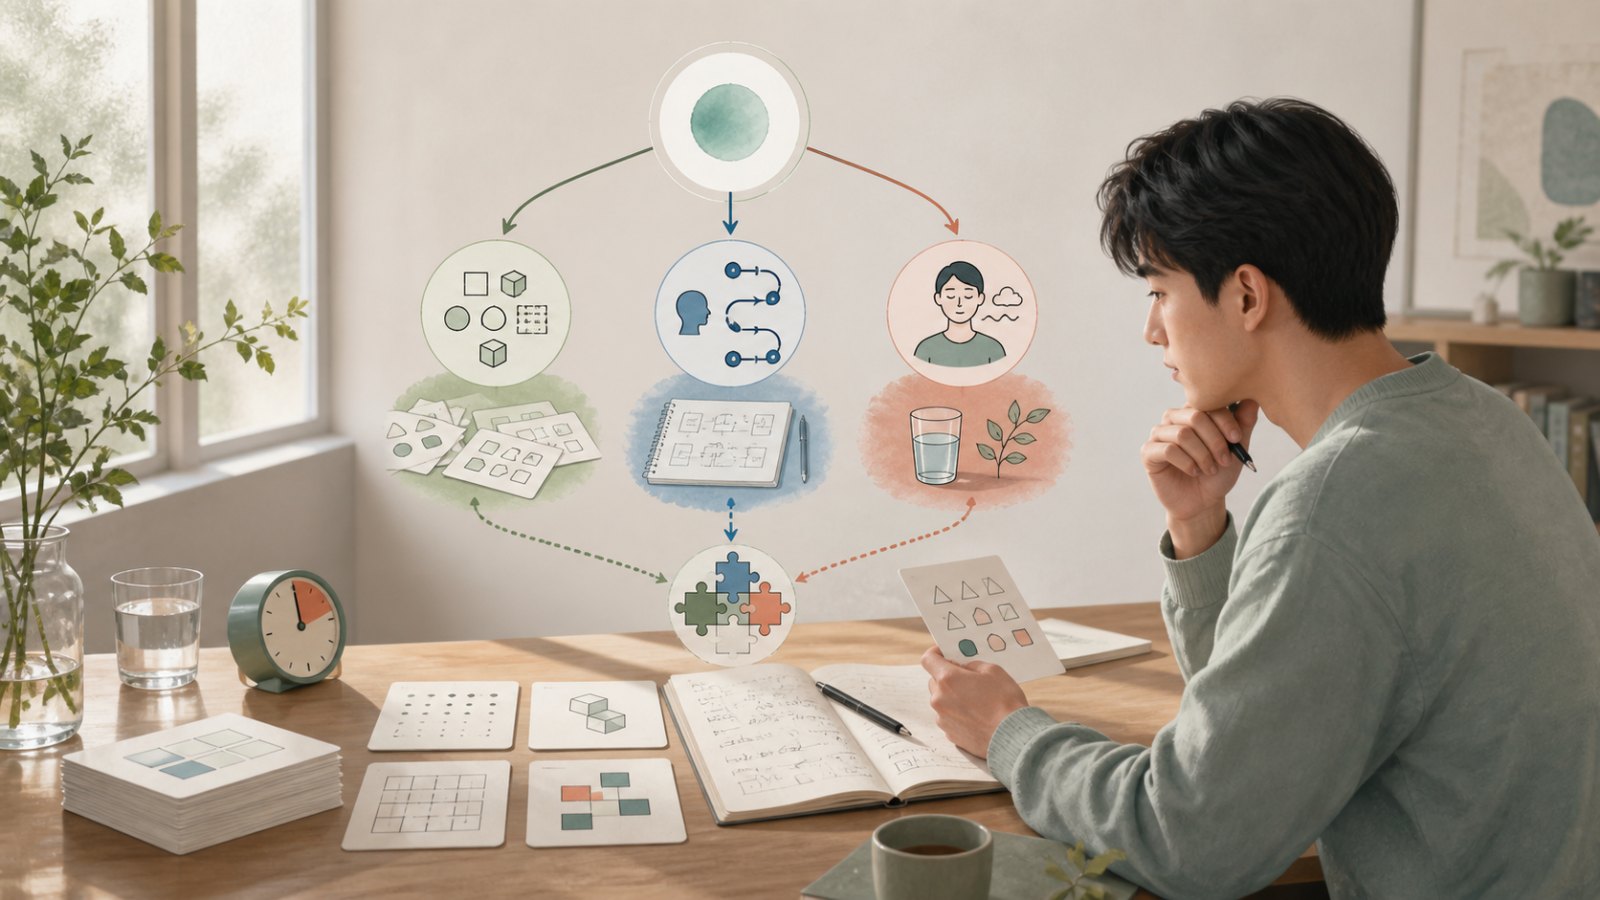
一次線上 IQ 或矩陣推理結果,首先表示你在特定題目、時間和環境中的本次表現,不是完整的智力描述。解讀時應從總分回到四層:題目要求、使用策略、當時狀態和結果不確定性。只有產品實際提供題型或過程資料時,才能進一步討論具體差異;沒有常模和分項證據時,不應推算人口百分位或給自己貼「高智商」「低智商」標籤。
為什麼只看總分容易誤解
同一個總分可能來自完全不同的過程:
- 一個人大部分題做得穩定,但在最後時間不足;
- 一個人速度很快,卻因過早確定規律出現集中錯誤;
- 一個人前半段被環境打斷,後半段恢復;
- 兩個人錯題數量相同,但錯誤型別完全不同。
總分把這些過程壓在一起。它適合做簡短彙總,卻不足以回答「我哪裡做得好、哪裡需要調整」。如果頁面只提供總分,就應誠實保留這種限制。
同樣 18/30,為什麼下一步可能不同
以下是虛構對照,假設兩份報告都只顯示答對 18/30,即正確率 60%。這是報告欄位;下面的過程資訊另來自虛構當事人的個人練習日誌,不是由報告推算出來的。
- 甲記錄:「我在幾道困難題上反覆嘗試,臨近自己預定的練習結束時間時,後面的題開始倉促作答。」這支持提出「時間分配可能失衡」的假設,卻不能證明時間不足就是全部錯誤的原因。下一步可在不同的外部練習材料中設定檢查點,記錄是否減少無效停留;若完成情況仍未改善,再檢查題目難度、知識或規則理解,而不是繼續壓縮時間。
- 乙記錄:「我有幾次只驗證了第一行,就認為其他位置也服從同一規則。」這支持提出「規則驗證可能不足」的假設,卻不能證明乙速度更快或屬於粗心型別。下一步可在新材料中寫出兩個候選規則,並找能區分它們的反例;若仍然出錯,再檢查是否遺漏條件,或候選規則本身都不適用。
僅憑兩份 18/30,無法判斷誰作答更快、誰受到干擾或誰用了哪種策略。即使報告提供總用時,也不能反推出每題用時。個人回憶可能不完整,應把「我記得發生過什麼」與「錯誤可能由什麼造成」分開記錄;沒有額外觀察時,只能保留待驗證的假設。
第一層:你完成的到底是什麼任務
先確認測驗由哪些題型組成、是否限時、是否允許返回修改、是否使用矩陣和圖形規律。不要把一種題型的表現擴充套件成全部認知能力。
矩陣推理通常要求從有限圖形中識別關係,但現實中的學習和工作還需要語言理解、知識、記憶、計劃、溝通、創造和長期堅持。一個人在視覺規律題上表現一般,並不能推出他在寫作、設計、社交判斷或專業實踐中也相同。
第二層:觀察策略,而不是猜人格
回顧時可以檢查:
- 是否先列舉可能變化,再選擇規則;
- 是否同時驗證行與列;
- 是否會用一個區域性規律解釋全部題目;
- 是否在困難題上停留過久;
- 是否修改了原本正確的答案;
- 是否依賴直覺,但無法說出依據。
這些是可以練習和調整的過程。它們不等於固定的智力,也不需要用人格型別解釋。檢查應依據當事人的觀察或合法練習日誌,不由總分補寫作答過程;只有確實提供逐題記錄的材料,才允許討論每題用時或改答。即使頁面顯示分組正確率或維度名稱,也只能先讀作該組題目的本次表現,不能據此建立穩定能力型別。
第三層:記錄本次狀態
至少記錄:
- 睡眠和疲勞;
- 是否焦慮或趕時間;
- 螢幕大小和圖形清晰度;
- 網路、噪音與中斷;
- 是否已經熟悉類似題;
- 是否使用了外部幫助。
狀態不是「找藉口」,而是記錄測量條件。也不要因為狀態不好就自動認定「真實水平一定更高」。可以先記錄中斷、疲勞等實際觀察,再在允許練習的不同材料和較穩定條件下檢查相似問題是否仍出現;題目難度或熟悉程度不同,也可能解釋差異。本文不給出費馬測試的最佳重測間隔,也不預估重測會提高多少分。
第四層:保留不確定性
任何測量都有誤差。線上環境還增加裝置、操作和自我選擇差異。沒有公開常模、信度與標準誤時,不能安全地給出「真實分數的範圍」。
可以這樣寫:
本次結果提示我在這一組矩陣與圖形規律任務中的表現。由於環境、題目範圍和常模資訊有限,我暫時不把它解釋為正式 IQ 或個人能力上限。
這不是削弱結果,而是讓結論與證據保持相同尺度。
要不要把結果告訴別人
線上測驗結果屬於個人資訊。你可以自願與信任的人討論學習策略,但不需要公開報告連結、完整作答記錄或可識別資訊。分享前先說明目的:「我想討論時間管理」,而不是邀請對方評價你的智力。
管理者、教師和伴侶也不應要求他人提交普通線上 IQ 結果來證明能力。招募、錄取和人員分配需要與任務匹配、經過審查的證據,不能用這類結果代替。即使使用者主動分享,也不應把一個數字寫進公開頁面、分析日誌或可搜尋資料。
如果別人用分數貶低或抬高你,可以把討論退回具體表現:完成了什麼任務、使用了什麼條件、有哪些證據和限制。個人價值不由一次線上測驗決定。
文章中的虛構案例也不應用來反推真實使用者。沒有題目級公開欄位時,編輯不能根據總分假裝知道某個人「速度快但粗心」或「空間能力更強」。可見資料到哪裡,敘事就應停在哪裡。
三個虛構案例
下面三個案例用於展示解讀方式,不代表真實使用者或診斷。各例的「觀察」是教學預設的個人練習記錄,例如獨立記錄的每題用時和回顧理由;「可能解釋」是待驗證假設,都不是總分自動生成的結論。若實際材料沒有這些記錄,就不能套用相應觀察。
案例一:速度快,但錯誤集中
觀察:多數題很快作答,若干錯誤集中在需要同時比較行與列的題。
可能解釋:過早採用單一規律,或時間策略偏向速度。
還需驗證:在不限時、允許練習的不同材料中,要求寫出排除理由,檢查是否減少只驗證區域性規律的錯誤。
若未改善:先檢查排除理由是否覆蓋全部已知條件;若規則仍無法解釋某個位置,就修改候選規則或補學所需概念,而不是把失敗歸為「天生粗心」。即使正確率提高,也要同時檢查新材料的難度與熟悉程度,不能僅憑前後變化認定策略造成了提高。
不能推出:這個人「粗心型」「智力不足」或一定適合快節奏工作。
案例二:正確率穩定,但用時較長
觀察:大部分題能給出一致理由,困難題停留時間長。
可能解釋:驗證步驟較多,或在沒有新線索時仍繼續嘗試同一路徑。
還需驗證:在允許跳題與返回的外部練習中,設定檢查點,記錄停留原因與整體完成情況。跳題不是本文對費馬作答功能的承諾;不允許跳題的材料,應遵守其規則。
若未改善:不要繼續縮短檢查點。先看是否因趕時間增加錯誤,再嘗試合併重複檢查、明確何時已有足夠依據,或減少練習量;較長用時也可能來自題目難度,而非個人速度特質。
不能推出:作答較慢就代表能力低,或謹慎一定是人格特質。
案例三:前後表現差異明顯
觀察:前半段錯誤較多,後半段逐漸穩定。
可能解釋:適應題型、開始時受到干擾,或逐漸發現通用策略。
還需驗證:在另一組允許練習的不同題目、較穩定環境中,記錄中斷、熟悉程度和所用策略,檢查類似錯誤是否仍然出現。
若未重複出現:仍只能說這次練習的觀察不同,不能確定是哪種因素造成。若錯誤持續,則檢查具體規則理解或材料難度,不再只用「開始時狀態不好」解釋。這裡比較的是同一次作答的前後半段,後半段穩定不能證明跨次能力變化或總智力提升。
不能推出:練習後總智力已經提升。
寫一段不貼標籤的結果敘事
使用模板:
在【日期和環境】完成【題型與用時】時,我觀察到【可見表現】。我主要使用【策略】,在【具體條件】下出現【錯誤或優勢】。可能解釋包括【至少兩個假設】;目前缺少【常模、分項或重測】證據,因此不把它解釋成【身分或正式結論】。下一步我會通過【一個低風險練習】驗證。
這段敘事比「我的 IQ 是多少,所以我是什麼人」更接近可回顧的證據。
分數變化應怎樣解釋
短期提高可能來自熟悉題型、記住規則、裝置變化或狀態改善;下降也可能來自疲勞、時間壓力或不同題目難度。若兩次測驗並非同一工具、同一計分和相似條件,分數尤其不宜直接比較。
不要為了得到滿意數字連續重測。連續重測會讓練習效應和結果焦慮更難區分。
結果可以怎樣用於下一步
- 如果想了解 FermatMind 測試的題量、作答和產品邊界,先看30 題工具說明;
- 如果已經識別具體錯誤機制,使用四周推理解題訓練指南;
- 如果關心線上分數與正式測驗的區別,閱讀線上 IQ 測驗準嗎。
測驗結果不應用於招募、升學錄取、診斷或證明個人價值。
常見問題
線上 IQ 測驗分數能換算成百分位嗎?
把百分位解釋成母體中的相對排名,需要適用常模、計分方法和明確的參照群體。模型參考百分位則描述指定模型分佈中的位置,不能據此認定超過了多少真實人。使用本次結果實際提供的合格參照;百分位不可用時保持不可用,不自行補算。
一次分數低需要立刻重測嗎?
通常不需要立刻重複。先記錄環境、題型和錯誤策略,避免把熟悉效應誤認為更準確。
為什麼我在不同網站得到不同分數?
題目、難度、計分、常模、限時和呈現方式可能不同。相同名稱不代表結果可以直接比較。
能從錯題看出具體認知缺陷嗎?
不能僅憑普通線上測驗診斷認知缺陷。錯題可以用於策略回顧;存在真實健康或學習擔憂時,應尋求適當專業評估。
結果能預測學習或職業成功嗎?
不能單獨預測。現實結果還受知識、動機、機會、健康、資源、協作和長期行為影響。
參考來源
- Mensa International:線上挑戰與正式測驗邊界:https://www.mensa.org/getting-your-iq-tested-faqs/
- AERA、APA、NCME:《Standards for Educational and Psychological Testing》概述:https://www.testingstandards.net/
- Deary, I. J. (2012). Intelligence. https://doi.org/10.1146/annurev-psych-120710-100353
這些條目提供進一步閱讀入口,不能替代具體工具、版本與用途的證據。關於重測,Hausknecht 等的統合分析摘要討論組織和教育選擇測驗,提示重複作答與輔導可能影響成績;不能據此為費馬設定最佳間隔或預期效應。本頁虛構案例和回顧動作是編輯示例,不是經這些來源驗證的診斷或介入方案。

